A ideia de criar o teu próprio modelo de previsão é sedutora. Em vez de dependeres de palpites, intuição, ou análises de terceiros, terias um sistema objetivo que processa dados e produz probabilidades. Equipas profissionais, casas de apostas, e apostadores de elite usam modelos — porque não tu? A boa notícia é que criar um modelo básico está ao alcance de qualquer pessoa com conhecimentos intermédios de matemática e vontade de aprender. A notícia mais sóbria é que criar um modelo que realmente funcione — que tenha edge sobre o mercado — é extraordinariamente difícil. Este artigo guia-te pelo processo, desde a conceção até à implementação, com honestidade sobre os desafios que vais enfrentar.
Um modelo de previsão é, na sua essência, um sistema que transforma dados em probabilidades. Alimentas o modelo com informação sobre um jogo — quem joga, onde, em que contexto — e ele produz estimativas de probabilidade para cada resultado possível. Estas probabilidades podem então ser comparadas com as odds das casas para identificar potencial valor. O modelo faz o trabalho pesado de síntese de informação; tu decides como usar as suas conclusões.
Passo 1: Definir o Objetivo
Antes de começar a construir, precisas de clareza sobre o que o modelo vai fazer. Parece óbvio, mas muitos projetos falham por falta de foco inicial.
Que mercado vais prever? Resultado final (1X2)? Golos totais? Handicaps? Cada mercado requer abordagem diferente. Um modelo para prever vencedores foca em força relativa das equipas; um modelo para prever golos foca em capacidades ofensivas e defensivas. Tentar prever tudo ao mesmo tempo tipicamente resulta em não prever nada bem.
Que ligas vais cobrir? Modelos precisam de dados para funcionar, e a quantidade e qualidade de dados variam entre ligas. As cinco grandes ligas europeias têm dados abundantes; ligas menores têm muito menos. Começar com uma liga bem coberta simplifica o desenvolvimento inicial.
Que horizonte temporal? Vais prever jogos uma semana antes? Um dia antes? Horas antes? Quanto mais cedo prevês, mais tempo tens para analisar mas mais incerteza existe sobre factores como lesões e alinhamentos. Modelos diferentes optimizam para horizontes diferentes.
Passo 2: Recolher Dados
Um modelo é tão bom quanto os dados que o alimentam. A recolha de dados é frequentemente a parte mais trabalhosa do processo, mas também a mais fundamental.
Os dados mínimos necessários para um modelo básico de futebol incluem resultados históricos de jogos, quem jogou em casa e fora, e a data do jogo. Com isto podes construir algo funcional. Mas modelos competitivos incorporam muito mais: estatísticas de jogo como remates, posse, xG; informação sobre jogadores como lesões e suspensões; dados contextuais como importância do jogo e condições meteorológicas.
Fontes gratuitas incluem o Football-Data.co.uk para resultados históricos e odds, FBref para estatísticas avançadas, e transfermarkt para valores de mercado e informação de plantel. Estas fontes cobrem as ligas principais adequadamente. Para dados mais detalhados ou ligas menores, plataformas pagas como Opta ou StatsBomb são necessárias.
A organização dos dados é crucial. Precisas de formatar tudo de forma consistente, lidar com dados em falta, e garantir que não há erros. Esta limpeza de dados consome tempo desproporcional mas é essencial — dados sujos produzem modelos que parecem funcionar mas falham quando aplicados.
Passo 3: Escolher a Abordagem
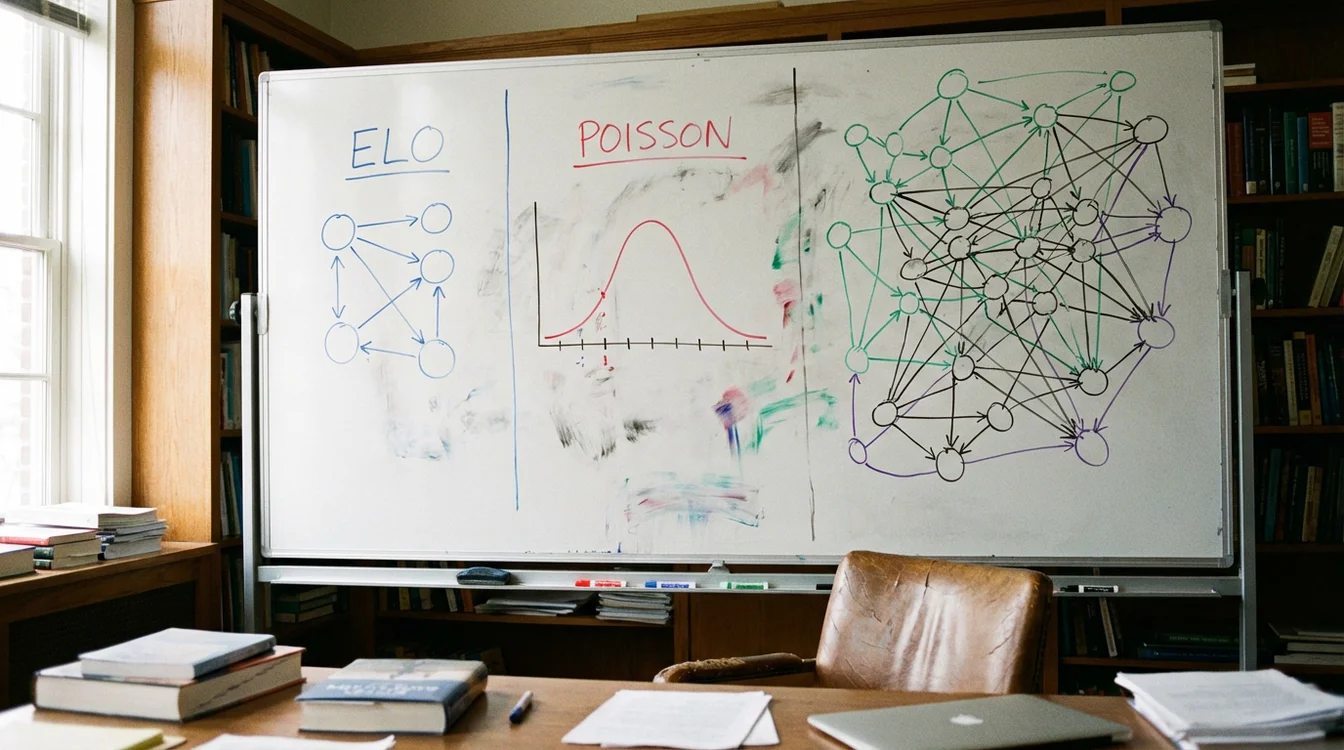
Existem várias abordagens para modelar futebol, cada uma com trade-offs diferentes.
A abordagem mais simples é o rating de equipas. Sistemas como o Elo atribuem um número a cada equipa que representa a sua força. Quando duas equipas jogam, a diferença de ratings prevê a probabilidade de cada resultado. O Elo original foi criado para xadrez mas adapta-se bem ao futebol com modificações. A vantagem é a simplicidade; a desvantagem é que ignora muita informação relevante.
Modelos baseados em golos, como o modelo de Poisson, estimam quantos golos cada equipa vai marcar e usam distribuições estatísticas para derivar probabilidades de resultados. Alimentas o modelo com taxas de golos ofensivos e defensivos de cada equipa, e ele calcula probabilidades para cada resultado possível. Esta abordagem é intuitiva e produz não apenas probabilidades de 1X2 mas também previsões para mercados de golos.
Modelos de machine learning usam algoritmos que aprendem padrões nos dados sem que tenhas de especificar explicitamente as relações. Podes alimentar o modelo com dezenas de variáveis — xG, posse, passes progressivos, forma recente — e deixar o algoritmo descobrir quais são preditivas e como combiná-las. A vantagem é a capacidade de encontrar padrões complexos; a desvantagem é a necessidade de grandes volumes de dados e o risco de overfitting.
Para iniciantes, recomendo começar com Elo ou Poisson simples. São compreensíveis, relativamente fáceis de implementar, e estabelecem uma baseline contra a qual modelos mais complexos podem ser comparados. Avançar para machine learning faz sentido depois de dominares os fundamentos.
Passo 4: Implementar o Modelo
A implementação requer alguma capacidade de programação. Python é a linguagem mais comum para este tipo de trabalho, com bibliotecas como pandas para manipulação de dados, scipy para estatística, e scikit-learn para machine learning. Se não tens experiência de programação, este é um investimento necessário — tutoriais online podem ensinar-te o básico em algumas semanas.
Para um modelo de Elo básico, a implementação segue estes passos: inicializas todas as equipas com rating igual; processas jogos históricos sequencialmente, atualizando ratings após cada jogo baseado no resultado e na diferença de ratings pré-jogo; no final, tens ratings atuais que refletem a força relativa de cada equipa. Para prever um novo jogo, calculas a probabilidade de cada resultado baseado na diferença de ratings.
Para um modelo de Poisson, calculas a média de golos marcados e sofridos de cada equipa, ajustando para força do adversário. Quando duas equipas jogam, estimas golos esperados de cada uma combinando as suas capacidades ofensivas com as fraquezas defensivas do adversário. Aplicas a distribuição de Poisson para calcular a probabilidade de cada resultado possível.
Documentação detalhada do código é importante. Meses depois, quando quiseres ajustar o modelo, precisas de compreender o que cada parte faz. Comentários claros e código organizado poupam tempo futuro significativo.
Passo 5: Validar o Modelo
Construir um modelo é relativamente fácil; validar que funciona é muito mais difícil. Muitos modelos parecem bons nos dados usados para os construir mas falham quando aplicados a novos dados.
O método fundamental de validação é o backtesting: testar o modelo em dados históricos que não foram usados na sua construção. Divides os dados em período de treino — usado para construir o modelo — e período de teste — usado para avaliar. O desempenho no período de teste é a melhor estimativa do desempenho futuro.
As métricas de avaliação incluem a calibração — se as probabilidades previstas correspondem às frequências reais — e a rentabilidade — se apostar seguindo o modelo produziria lucro. Um modelo pode estar bem calibrado mas não ser rentável se não superar a margem das casas. Inversamente, um modelo ligeiramente mal calibrado pode ser rentável se tiver edge suficiente nos casos que recomenda apostar.
O Log Loss é uma métrica técnica comum que penaliza previsões confiantes erradas. Comparar o Log Loss do teu modelo com o Log Loss das odds das casas indica se estás a fazer melhor ou pior que o mercado. Se o teu Log Loss é consistentemente inferior, tens potencialmente edge.
A validação honesta é crucial e difícil psicologicamente. É fácil ajustar o modelo para que pareça bom nos dados de teste — mas isto é batota que só te engana a ti próprio. A única validação válida é aquela feita em dados que nunca viste antes de fixar os parâmetros do modelo.
Passo 6: Iterar e Melhorar
Um modelo inicial é apenas o ponto de partida. A melhoria contínua é necessária para manter e desenvolver edge.
A adição de variáveis é uma forma óbvia de melhoria. Se o teu modelo inicial usa apenas resultados históricos, adicionar xG pode melhorar as previsões. Se usa xG, adicionar informação sobre lesões pode ajudar. Mas cuidado com adicionar variáveis indiscriminadamente — cada variável adicional aumenta a complexidade e o risco de overfitting.
O ajuste de parâmetros pode melhorar desempenho. No Elo, o factor K determina quanto os ratings mudam após cada jogo; valores diferentes de K produzem modelos diferentes. Testar vários valores e escolher o que produz melhor validação é parte do processo.
A análise de erros é informativa. Quando o modelo falha significativamente — previu 70% e o resultado oposto aconteceu — vale a pena investigar porquê. Há informação sistemática que está a ignorar? Há tipos de jogos onde falha consistentemente? Estas observações guiam melhorias futuras.
A humildade é essencial ao longo deste processo. Mesmo modelos sofisticados têm limitações significativas. O futebol tem componente aleatória irredutível; nenhum modelo prevê com certeza. Esperar que o teu modelo seja sempre certo é receita para frustração. Esperar que seja ligeiramente melhor que o mercado em certas situações é expectativa realista.
Considerações Finais
Criar um modelo de previsão próprio é projeto ambicioso que requer investimento significativo de tempo e esforço. As competências necessárias — programação, estatística, conhecimento de futebol — levam meses ou anos a desenvolver. E mesmo com competência, criar edge sobre mercados eficientes é extraordinariamente difícil.
Os benefícios vão além do edge potencial. O processo de construir um modelo aprofunda a tua compreensão do futebol, da estatística, e das apostas. Mesmo que o modelo não produza lucro imediato, o conhecimento adquirido melhora a tua capacidade de analisar jogos e avaliar informação.
A recomendação para iniciantes é começar simples: um modelo de Elo básico para uma liga que conheças bem. Aprende com este exercício, valida honestamente, e só depois considera adicionar complexidade. Muitos abandonam projectos de modelação porque começam demasiado ambiciosos; o caminho sustentável é a construção gradual de competência.
Se no final concluíres que não tens edge — que o mercado é mais inteligente que o teu modelo — não é fracasso. É informação valiosa. Saberás que as tuas apostas devem basear-se noutras fontes de vantagem, ou aceitar que apostas por entretenimento em vez de lucro. Esta honestidade, por mais que doa, é preferível à ilusão de competência que custa dinheiro real.